

プリプレスプロセスの速度を再び低下させないでください。自社開発ツールにより、効率が 10 倍近く向上しました。{0}
開発背景:生産現場のニーズから生まれた
デジタル印刷におけるプリプレス文書の処理には時間がかかりすぎます。最前線のオペレーターとコミュニケーションをとった結果、3 つの主要なニーズが特定され、明確になりました。
(1) 文書のページ数をバッチチェックする: 印刷およびレイアウト中に、文書のページ数が偶数であることを確認する必要があることがよくあります。そうしないと、印刷材料の無駄や製本ミスが発生しやすくなります。
(2) 奇数ページのドキュメントの自動処理: 奇数ページのドキュメントの場合、最後に空白ページを追加する必要がありますが、偶数ページは変更されません。
(3) テキストが湾曲しているかどうかを一括チェックする: フォントの欠落による印刷エラーを避けるために、文書内のテキストが曲線に変換されている (つまり、「湾曲している」) ことを確認します。
Adobe Acrobat および市場のさまざまな PDF 処理プラグインに関する調査を通じて、既存のツールは機能的に冗長で複雑であるか、特に反転処理のセキュリティに隠れたリスクがあるなど、企業の実際の制作プロセスに適合していないことが判明しました。さらに重要なのは、同様の国内ツールは支払いが必要な場合が多く、長期的な使用コストが高くなります。-これらの実際的な問題に基づいて、同社は軽量で正確な、社内でカスタマイズされた専用ツールを開発することを決定しました。
PDFページ数チェック・処理ツール
01
コア機能と判定ロジック
このツールの主な目的は、印刷するすべてのドキュメントのページ数を確実に偶数にすることです。判断と実行の考え方は以下の通りです。
(1) ページ検出メカニズム: PyMuPDF ライブラリを介して PDF ドキュメントのメタデータを読み取り、総ページ情報を直接取得します。
(2) パリティ論理判定:剰余演算(ページ番号 %2)を用いてパリティを判定します。結果が 1 の場合、奇数ページであると判断されます。 0 の場合は偶数とみなされます。
(3) 差別化された処理戦略: 奇数ページの場合は、元のドキュメント サイズと一致する 1 つの空白ページをドキュメントの末尾に自動的に追加します。偶数ページのドキュメントの場合は、コンテンツを変更せずに出力ディレクトリに直接コピーします。
(4) セキュリティ処理原則: 図 1 に示すように、処理されたすべてのドキュメントは指定された「処理済みファイル」ディレクトリに保存され、誤操作によるファイルの損傷を避けるために元のファイルも保存されます。
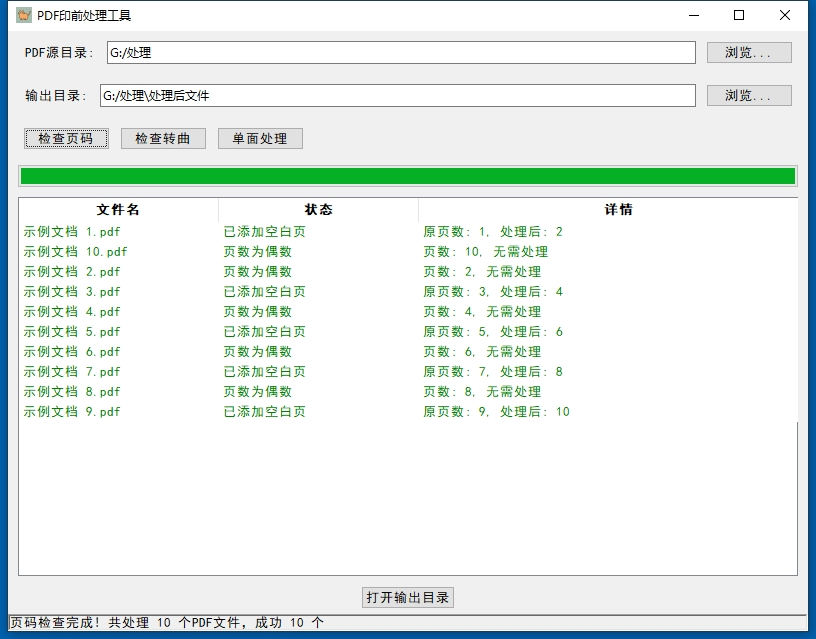 図 1 PDF ページ数チェックおよび処理ツールのインターフェイス
02
技術的な実装ポイント
このツールは Tkinter を使用してグラフィカル インターフェイスを構築し、主に 3 つの機能モジュールが含まれています。
(1) ディレクトリ選択モジュール: ソース ファイル ディレクトリと出力ディレクトリの視覚的な選択をサポートします。デフォルトの出力ディレクトリはソース ディレクトリの下のサブフォルダです。
(2) バッチ処理モジュール: マルチスレッド技術を使用してバックグラウンド処理を実行し、インターフェースのフリーズを回避し、同時にプログレスバーを通じて処理の進行状況をリアルタイムで表示します。
(3) 結果表示モジュール:各ファイルの処理結果(元のページ数、処理アクション、ステータス情報など)を表形式で表示し、成功と失敗の状態を色で区別します。
PDF曲線変換チェックツール
01
コア機能と判定ロジック
曲線変換チェック ツールは、文書内のテキストが曲線に変換されているかどうかを判断することに重点を置いています。その中核となる判断ロジックは、PDF ドキュメント内のフォント情報の分析に基づいています。
(1) テキスト存在検出: ページからテキストを抽出することにより、文書に編集可能なテキストが含まれているかどうかを判断します。
(2) フォント情報分析: ドキュメントに埋め込まれたフォントのリストを解析します。フォント情報が存在する場合は、テキストが曲線に変換されていないことを示します。
(3) 総合的な判定ルール: テキストコンテンツがあり、フォント情報がない場合は、テキストが曲線 (緑色のマーク) に変換されていることを示します。テキストコンテンツがない場合、変換は必要ありません (緑色のマーク)。テキスト コンテンツとフォント情報がある場合、図 2 に示すように、テキストは曲線 (赤いマーク) に変換されていません。
このツールは、「チェックのみ、変換しない」モードで特別に設計されています。主な理由は、オペレーターのフィードバックによると、公印を含むファイルに対してカーブ変換を実行すると、印鑑やその他のグラフィックが失われやすいため、ツールはチェック機能のみを残しています。
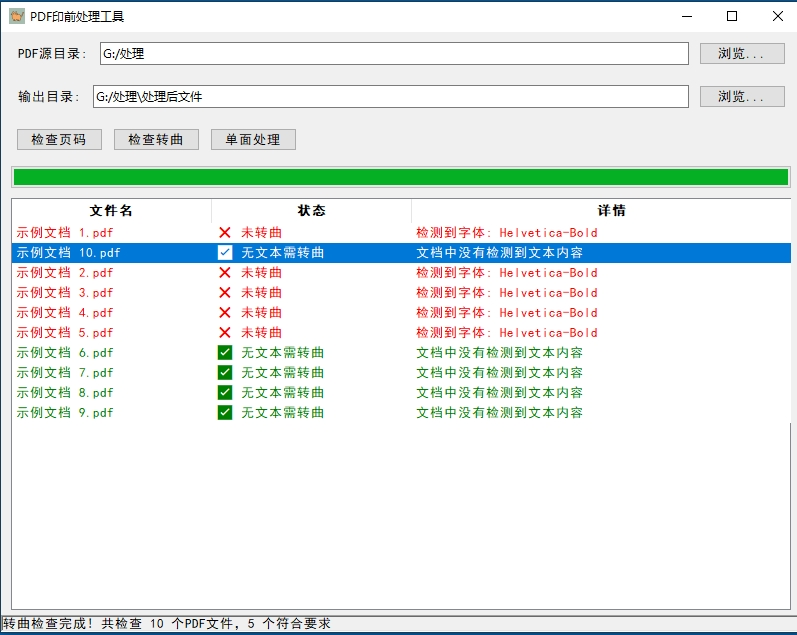
図2 PDF曲線チェックツール
02
主要な技術的実装ポイント
また、このツールは Tkiner を使用してインターフェースを構築しており、3 つの重要な技術点があります。
(1) フォント情報の抽出: PyMuPDF のテキストブロック解析機能を使用して、文書内のすべてのフォント名とその出現数を取得します。
(2) 結果の可視化: 検査結果をツリービューで表示し、色とアイコンで状態を直感的に区別できます。
(3) 状況統計機能:要件を満たす書類の数を自動計算し、検査全体の状況を迅速に把握できます。
開発プロセスにおける課題と解決策
私はプロではない開発者として、ツールの開発中に多くの技術的な課題に遭遇しました。{0}具体的な問題点と解決策は以下の通りです。
(1) PDF 解析深度の問題: 初期の PDF ライブラリではフォント情報を正確に抽出できませんでしたが、AI の提案後、PyMu PDF ライブラリに切り替えることで問題は解決されました。
(2) インターフェイスの遅延の問題: 大量のファイルをバッチで処理すると、インターフェイスが応答しなくなることがよくあります。 AI の指導の下、マルチスレッド処理ソリューションが実装され、この問題が効果的に解決されました。
(3) 中国語の文字化け: フォント パラメータとエンコード設定を構成することにより、インターフェイスおよびエクスポート ファイルに表示される中国語の文字化けの問題が解決されます。
(4) 例外処理メカニズム: PDF ファイルの破損によって引き起こされるプログラムのクラッシュの問題に対処するために、単一のファイルの障害がプロセス全体に影響を与えないよう、例外キャプチャ メカニズムが改善されました。
開発プロセス全体を通じて、AI ツールは技術コンサルタントとして重要な役割を果たし、主要なコード例を提供するだけでなく、PDF ファイル形式の解析原理を説明し、開発者が専門知識を迅速に把握できるように支援しました。
ツールアプリケーションの価値と展望
これら 2 つのツールの適用により、特に次の 2 つの側面で生産作業の効率が大幅に向上しました。
(1) 時間コストの削減:これまで 1 時間かかっていた手動検査が 5 分で完了し、効率が 10 倍近く向上しました。
(2) 品質安定性の向上: 手動検査による見落としを効果的に回避し、安定した印刷品質を保証します。
これら 2 つのガジェットの開発プロセスを文書化することは、実際の生産における特定の問題を解決し、技術的手段を通じて従来のワークフローを最適化し、最終的にコスト削減と効率向上を達成することに焦点を当てた「探求と革新」という仕事哲学を伝えることを目的としています。