


プレプレスワークフローを遅くさせないでください!私たちの自己-開発されたツールは、効率を10倍近く増やしました
開発の背景:実際の生産ニーズに由来します
デジタル印刷用のプリプレスドキュメント処理は、時間がかかりすぎます。最前線のオペレーターと通信した後、3つのコア要件が特定され、確認されました。
(1)バッチチェックドキュメントページ番号:印刷とタイプセットでは、ドキュメントページ番号が均等であることを確認する必要があることがよくあります。そうしないと、印刷資料や拘束力のあるエラーの無駄につながる可能性があります。
(2)奇妙なページドキュメントを自動的に処理する:奇数ページのドキュメントの場合、空白のページを最後に均一に追加する必要がありますが、ページさえあるドキュメントは変更されません。
(3)テキストの変曲のバッチチェック:フォントの欠落に起因する印刷エラーを回避するには、ドキュメント内のテキストが曲線(つまり「変動」)に変換されているかどうかを確認する必要があります。
Adobe Acrobatと市場のさまざまなPDF処理プラグインに関する研究を通じて、既存のツールには冗長で複雑な機能があるか、特にファイルの変換におけるセキュリティリスクの観点から、会社の実際の生産プロセスと一致しないことがわかりました。さらに重要なことに、国内で生成された同様のツールは、多くの場合、支払いが必要であり、より高い-用語の使用コストをもたらすことです。前述の実用的な問題に基づいて、同社は軽量で正確な、内部的に互換性のある専門的なツールを開発することを決定しました。
PDFページのチェックおよび処理ツール
01
コア関数と判断ロジック
このツールの中心的な目標は、印刷されるドキュメントのすべてのページが均等になり、その判断と実行のアプローチが次のとおりであることを確認することです。
(1)ページ検出メカニズム:PYMUPDFライブラリを介してPDFドキュメントのメタデータを読んで、合計ページ情報を直接取得します。
(2)パリティ判決ロジック:Modulo操作(ページ番号%2)を使用して、パリティを決定します。結果が1の場合、それは奇数ページとして審査され、結果が0の場合、偶数ページとして審査されます。
(3)分化処理戦略:奇数の文書の場合、ドキュメントの最後にある元のドキュメントと同じサイズの空白ページを自動的に追加します。均等なページドキュメントの場合は、コンテンツを変更せずに保管して、出力ディレクトリに直接コピーします。
(4)セキュリティ処理の原則:すべての処理されたドキュメントは、指定された「処理されたファイル」ディレクトリに保存され、図1に示すように、誤操作によるファイルの損傷を避けるために元のファイルは変更されていません。
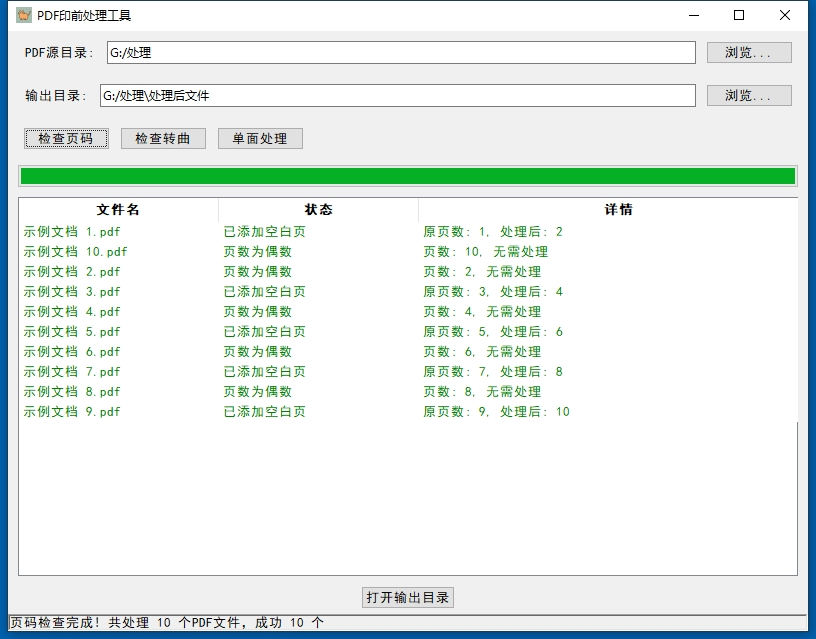 図1 PDFページのチェックおよび処理ツールインターフェイス
02
技術実装の重要なポイント
このツールは、TKINTERを使用してグラフィカルインターフェイスを構築します。これには、主に3つの機能モジュールが含まれます。
(1)ディレクトリ選択モジュール:ソースファイルディレクトリと出力ディレクトリの視覚的な選択をサポートし、デフォルトの出力ディレクトリはソースディレクトリの下のサブフォルダーです。
(2)バッチ処理モジュール:Multi -スレッドテクノロジーを使用して、バックエンド処理を実装し、インターフェイスの遅延を回避し、進行状況バーを介して実際の-時間で処理の進行状況を表示します。
(3)結果表示モジュール:元のページ番号、処理アクション、ステータス情報など、各ファイルの処理結果をテーブル形式で提示し、成功した状態と故障状態を色で区別します。
PDF変換チェックツール
01
コア関数と判断ロジック
曲線チェックツールは、ドキュメント内のテキストが曲線に変換されたかどうかを判断することに焦点を当てており、そのコアジャッジメントロジックは、PDFドキュメントのフォント情報の分析に基づいています。
(1)テキストの存在検出:ページテキスト抽出関数を使用して、ドキュメントに編集可能なテキストが含まれているかどうかを判断します。
(2)フォント情報分析:ドキュメントに埋め込まれたフォントのリストを分析します。フォント情報がある場合、テキストが変換されていないことを示します。
(3)包括的な判決規則:テキストコンテンツがあるがフォント情報がない場合、曲が変換されたことを示します(緑色でマークされています)。テキストコンテンツはありません。トラックを切り替える必要がないことを示しています(グリーンラベル)。テキストコンテンツとフォント情報がある場合、図2に示すように、曲が変換されていない(赤でマークされていない)ことを示します。
このツールは、主にオペレーターからのフィードバックによると、公式シールを含むファイルでコンバージョン操作を実行するときに、公式シールやその他のパターンの損失を引き起こすことが簡単であるため、「変換なしでのみチェック」モード用に特別に設計されています。したがって、チェック関数のみが保持されます。
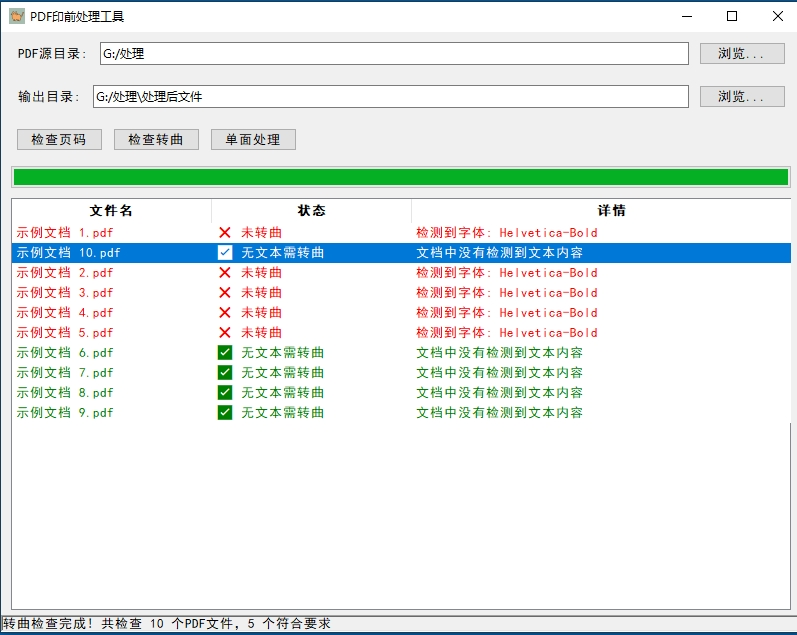 図2 PDF変換チェックツール
02
技術実装の重要なポイント
このツールはTKINTERを使用してインターフェイスを構築し、重要な技術ポイントには次の3つのポイントが含まれます。
(1)フォント情報抽出:PymUPDFのテキストブロック分析関数を使用して、ドキュメントで使用されるすべてのフォントの名前と発生を取得します。
(2)結果の視覚化:ツリービューを使用して検査結果を表示し、色とアイコンを通して異なる状態を視覚的に区別します。
(3)ステータス統計関数:要件を満たすファイルの数を自動的に計算し、オペレーターが全体的な検査状況を迅速に把握するのに役立ちます。
開発プロセスにおける困難と解決策
非専門的な開発者として、私はツール開発プロセス中に多くの技術的課題に遭遇しました。特定の問題と解決策は次のとおりです。
(1)PDF解析深度の問題:使用された最初のPDFライブラリは、フォント情報を正確に抽出できませんでした。 AIの推奨の後、PymupDFライブラリに置き換えることで解決されました。
(2)インターフェイスLAG問題:多数のファイルを大量に処理する場合、インターフェイスは反応しない状態になりやすい。 AIのガイダンスにより、この問題を効果的に解決するために、マルチ-スレッド処理ソリューションが実装されています。
(3)中国のディスプレイ文字化文字:フォントパラメーターとエンコード設定を構成することにより、インターフェイスとエクスポートされたファイルに文字化された文字を表示する中国の展示の問題が解決されました。
(4)例外処理メカニズム:損傷したPDFファイルによって引き起こされるプログラムクラッシュの問題に応じて、個々のファイル処理の障害がプロセス全体に影響を与えないように、例外キャプチャメカニズムが改善されました。
開発プロセス全体を通して、AIツールはテクニカルコンサルタントとして重要な役割を果たし、重要なコードの例を提供するだけでなく、PDFファイル形式の解析の原則を説明し、開発者が専門的なドメインの知識を迅速に理解できるようにしました。
ツールアプリケーションの価値と見通し
これら2つのツールを適用すると、生産作業に大幅な効率改善がもたらされました。これは、次の2つの側面に反映されています。
(1)時間コストの節約:元々1時間を必要とした手動検査作業は5分で完了し、効率を10倍近く増加させることができます。
(2)品質安定性の向上:手動検査の省略を効果的に回避し、安定した印刷品質を確保する。
これら2つの小さなツールの開発プロセスの記録は、「探査と革新」の仕事哲学を伝え、実際の生産における特定の問題の解決、技術的手段を通じて従来のワークフローを最適化し、最終的にコスト削減と効率改善の目標を達成することに焦点を当てることを目的としています。